前言
最近在折腾 Bangumi 二度好友发现组件(用户脚本),大体功能就是沿着 Bangumi 好友关系顺藤摸瓜,看看好友都加了哪些你没加的婆罗门同好。
测试的时候吃着火锅还唱着歌,正快快乐乐扫到一半呢,组件突然就给卡死了,干什么都没用。调试下来一看,怎么某些好友数量极其庞大的用户解析得这么慢?
原生死于此树下
Bangumi 好友列表结构非常朴素,一个大列表容器下面平铺着所有好友条目:
<ul id="memberUserList">
  <!-- 整整平铺了约 5.8 万个并列的 li.user 兄弟节点 -->
  <li class="user">
    <div class="userContainer">
      <strong>
        <a class="avatar" href="/user/synthetic">Example</a>
      </strong>
    </div>
  </li>
  <!-- ... 下略数万个 ... -->
</ul>
组件需要逐条校验列表里每个 li.user(以下代码中的 item),从中定位用户链接并解析资料。但就在这个大列表循环里,原版选择器能让扫描进度卡死十几接近二十秒。这谁受得了?看看能不能让 agent 优化一下。
很快啊,改进方案就端上来了。agent 把
const anchor = item.querySelector(".userContainer > strong > a.avatar[href]");改成了
const anchor = [...item.querySelectorAll("a.avatar[href]")].find(
  (link) =>
    link.parentElement.matches("strong") &&
    link.parentElement.parentElement?.matches(".userContainer"),
);
哦哦哦!改完之后扫描时间直接从 19 秒降到了 1 秒!哎呀,真是非常的新鲜,非常的美味啊!这下舒服了……
不是,为什么啊?
不对啊,这俩逻辑也没啥区别啊?原来的写法是对每个好友条目调用整个选择器,优化后的写法则是先抓出目标链接,然后在 JavaScript 里手动检查两层父节点。展开写得直观点,逻辑上等价于:
let anchor;
for (const link of item.querySelectorAll("a.avatar[href]")) {
  const parent = link.parentElement;
  const grandParent = parent.parentElement;

  if (parent.matches("strong") && grandParent?.matches(".userContainer")) {
    anchor = link;
    break;
  }
}
正常来说,原生 CSS 选择器是浏览器底层 C++ 引擎驱动的,按道理应该各种神秘优化拉满,怎么说都不该比手写 JS(还带着 agent 特有的 querySelectorAll + find 过度防御)这种看起来就全是运行时代价的方法慢啊?
既然搞不懂,那为什么不问问神奇海螺 ChatGPT 呢?
我:为什么简单选择器 + 手写 JS 过滤比复杂选择器快?
GPT(吭哧吭哧干了半天):真实浏览器的首轮实测出现了一个重要反例:在 Chromium 144、与仓库结构相同的合成好友列表中,原来的完整选择器反而明显更快。
不是,还反了你了?
源码三百六十五里路
等等,GPT 用的是 Chromium 144?版本对不上,我本地 Edge 现在已经 155 了……难道说?
谷歌你更新 Chromium 给我更新好了啊喂!哪还有性能开倒车的?
既然怀疑是新版引入的性能退化,那就让哈 GT 沿着 Blink 源码去扒一扒谷谷歌歌的底裤罢。
献给快速路径的状态机
最终一路追到了 third_party/blink/renderer/core/css/selector_query.cc。Chromium 负责执行查询的核心类叫 SelectorQuery,翻看提交历史,发现它在 2026 年 6 月做了一次重构 CL 7876624。不过这个重构当天就因为测试失败被回滚了,次日由 CL 7900254 重新合入,最终随 Chromium 151 发布。
传统 CSS 规则匹配因为目标元素已经确定了,通常从右向左反查祖先。但 querySelector 面对的是一整棵未知子树,挨个遍历一遍的话祖先链上的重复检查未免过多了。
以前 Blink 针对 .class、#id、标签匹配以及一些特定组合器模式,专门实现了大约八类快速路径。这次重构试图把以前零散的快速路径统一改写,变成一套通用的从左向右、自顶向下的 mini-checker 状态机。
简单来说,它会先把选择器按组合器(>、+、~、空格)切分成一段段复合选择器(compound),再把每个 compound 当作一个状态,自顶向下遍历 DOM 时逐步推进,快速筛选候选元素。为了避免状态机过度复杂,它还会故意放宽某些组合器,例如把直接子代 > 当成后代,以及把相邻兄弟 + 当成一般后续兄弟。
总之,这套 mini-checker 负责快速找出可能成立的候选。如果遇到不能直接判断的复杂条件,就留给后面的完整检查处理。
这看着不赖嘛,有啥问题吗?
不/存在的边界,和兄弟
目前可公开的情报:
- 当我们在条目上调用
item.querySelector(...)时,item会作为查询根节点(代码里的root_node)传入引擎。- 按照 W3C Selectors 规范,当我们在某个元素上调用
element.querySelector("ancestor descendant")时,虽然最终匹配的目标元素得是element后代,但选择器左侧针对祖先或前置兄弟的条件,是允许匹配到element外部节点的(所以才需要:scope让选择器可以显式锚定到调用元素本身)。
好麻烦啊……看来在进入 root_node 子树之前,还得先回头看看外部的祖先和前置兄弟里,有没有已经满足的前置条件。
于是 Blink 引入了 FirstCompoundNotSeenBeforeRoot,用来估计状态机在 root_node 处能把起点下标往后推多远,以跳过已在外部见过的 compound。这个估计宁可大不可小,估大也就多放几个候选进来,反正最后有完整检查兜底,但估小可就直接漏结果了。
小葵花妈妈课堂开课啦!组合器分为两类,
>和空格连接的是父子、祖先后代,在 DOM 树里是纵向关系;+和~连接的是兄弟,是横向关系。被兄弟组合器串起来的一组 compound 位于 DOM 同一层,纵向组合器则是层与层的分界。
compounds_按选择器从左到右排列,最后一项对应目标,拿.userContainer > strong > a.avatar[href]举例的话就类似于[.userContainer, strong, a.avatar[href]]。
FindStartOfLevel(i)返回下标为i的 compound 所在层的第一个下标。比如a + b > c ~ d分成{a, b}和{c, d}两层,FindStartOfLevel(3)返回 2。而我的选择器全是>,每个 compound 各占一层,FindStartOfLevel(i)恒等于i。
const unsigned subject_compound_idx = compounds_.size() - 1;

// 1. 向上:恢复祖先方向匹配状态
unsigned start_compound_idx = FirstCompoundNotSeenBeforeRoot(
    root_node, /*from_idx=*/0,
    /*to_idx=*/FindStartOfLevel(subject_compound_idx),
    is_html_doc, /*horizontally=*/false);

// 2. 若在某一层半途卡住,回退到该层起点
start_compound_idx = FindStartOfLevel(start_compound_idx);

// 3. 向左:恢复前置兄弟方向匹配状态
start_compound_idx = FirstCompoundNotSeenBeforeRoot(
    root_node, /*from_idx=*/start_compound_idx,
    /*to_idx=*/subject_compound_idx,
    is_html_doc, /*horizontally=*/true);
有一说一,我的选择器 .userContainer > strong > a.avatar[href] 里清一色全是子代组合器 >,根本没有 + 或者 ~ 这种兄弟组合器啊?既然没有兄弟关系,为何还会触发横向扫描?
顺着源码走一遍吧。向上查祖先的逻辑倒不难理解,直接代入计算:subject_compound_idx 是 2,每个 compound 各占一层,所以 FindStartOfLevel(2) 是 2,第 1 步的范围是 [0, 2)。祖先里没能匹配上,start_compound_idx 依然是 0,第 2 步回退后还是 0。
来到第 3 步……等等,先让我思考思考向左查兄弟到底是想干啥……
我想想……在 DOM 树里,root_node 的前置兄弟只和 root_node 自己是同层兄弟。状态机进入主搜索时,也确实会先从 root_node 自身开始匹配,只是它自己不能作为最终目标返回。
如果有一个选择器 .p + .q .r,root_node 是 .q,它前一个兄弟是 .p。那只要前置兄弟先帮它销掉 .p,把起点推到层尾 .q,进入主搜索之后 root_node 自己再对上 .q,{.p, .q} 这一层就凑齐了,进子树时只管找 .r。
哦!所以第 3 步就是在找左边的兄弟能不能帮 root_node 凑齐自己这一层啊。
这么看下来,比 start_compound_idx 更浅的层归祖先管,最后那层目标层因为 root_node 自己不能是最终目标,目标以及和它同层的兄弟就全得在 root_node 子树内部找。只有起点还停在目标层之前某一层的时候,才需要让外面的前置兄弟帮忙凑这层前面的项,把层尾留给 root_node 自己匹配。
也就是说,只要起点还没落进目标层,第 3 步的区间就应该是 [start_compound_idx, 本层层尾下标)。一旦起点已经落进目标层,干脆就不用扫前置兄弟了。我的选择器里祖先没能匹配上,起点的 .userContainer 这一层只有一个 compound,所以理应留下个不用看兄弟的空区间。
让我们来看看 Blink……好家伙,终点直接给到了 subject_compound_idx?结果最终调用了 [0, 2) 这个横跨两层的范围,让纵向 compound 也原封不动塞进了横向查找。
那被调用函数内部呢?看看 FirstCompoundNotSeenBeforeRoot 内部是如何初始化待匹配项计数的:
// 传入范围 [from_idx, to_idx),检查这些前置 compound 是否在 root_node 外部已见过
unsigned SelectorQuery::FirstCompoundNotSeenBeforeRoot(
    const ContainerNode& root_node, unsigned from_idx, unsigned to_idx,
    bool is_html_doc, bool horizontally) const {
  // 如果待检查区间为空,直接返回(注意看,这个判断叫小帅)
  if (from_idx == to_idx) {
    return from_idx;
  }

  // 取出需要检查的前置 compound 切片
  base::span<const Compound> earlier_compounds =
      base::span(compounds_).subspan(from_idx, to_idx - from_idx);

  // 初始化待匹配项计数器
  unsigned num_unmatched_compounds = 0;
  for (const Compound& compound : earlier_compounds) {
    if (!horizontally && compound.next_compound_is_horizontal) {
      // 向上查祖先时,如果该 compound 后面接的是兄弟组合器,就当作已见过跳过
      compound.seen_before_root = true;
    } else {
      compound.seen_before_root = false;
      ++num_unmatched_compounds;
    }
  }
  // 下接遍历 parentNode() 或 previousSibling()
  // 最后返回首个仍未见过的下标(全都见过则返回 to_idx)
}
可以看到向上查祖先时,代码会把后面接兄弟组合器的 compound 标记为已见过。既然往上走看不到祖先的兄弟,那就把前置兄弟项都先放行,只检查层尾。要是层尾在祖先那儿没匹配上,返回下标就会停在这一层半路,再靠前面第 2 步的 FindStartOfLevel 把它退回该层起点重来。
不过初始化循环只给向上的情况走了特例,横向的时候一律计数。可以看看 selector_query.h 里的注释是怎么写的:
// The same goes for compounds to the left of the root (horizontally=true),
// once we've discovered what is our top level.
好好好,看起来横向扫描原本就假定调用方只传入当前那一层,压根没防着纵向组合器混进来。于是第 3 步塞进来的 [0, 2) 里,虽然 .userContainer 和 strong 后面接的都是 >,却照样被算作“需要去前置兄弟里找”。num_unmatched_compounds 就这样累加成了 2。
因此,Blink 就带着这个大于 0 的计数器,信心满满地杀进了横向扫描循环:
for (const Node* node = horizontally ? root_node.previousSibling()
                                     : root_node.parentNode();
     node && num_unmatched_compounds;
     node = horizontally ? node->previousSibling() : node->parentNode()) {
  // 逐个匹配前置 compound,如果匹配成功就 --num_unmatched_compounds
}
都说了前置兄弟全是 li.user,根本不可能匹配这两个 compound 啊!毕竟这两个 compound 和目标之间本来就是纵向关系,在兄弟里找它们本身就没有意义嘛。
因此 num_unmatched_compounds 一直无法归零,循环没有提前结束的机会,老老实实顺着 previousSibling() 一路向左,把前面所有兄弟节点全扫了个遍……
热知识:在 Document 上查询时,根节点的
parentNode()和previousSibling()原生就是nullptr,循环一开始就退出了。因此全文档的document.querySelector不会出现这个问题,得在拥有大量前置兄弟的元素上调用才会踩到这颗地雷。
17 亿次即刻轮回
好家伙,一个本来应该在固定小子树内解决的常数查询,硬生生退化成了与前置兄弟数量成正比的
而 agent 改出来的写法之所以能秒过,原因也很清晰:
a.avatar[href]内部没有任何组合器,此时整个选择器只剩这一个 compound,subject_compound_idx自然是 0。于是两次调用都成了空区间,小帅判断from_idx == to_idx成立并跳过了这套外部扫描逻辑。- 拿到链接后,在 JavaScript 里直接读取
link.parentElement向上跳两层指针验证。这纯粹是常数时间开销,与列表长度以及当前条目前积压了多少兄弟毫无关系。
回到拥有约 5.8 万好友的真实大户页面,在控制台里按位置打点测试一下:
| 列表位置 | 单次平均耗时 |
|---|---|
| 1,000 | 10.0 μs |
| 5,000 | 60.0 μs |
| 10,000 | 116.7 μs |
| 20,000 | 240.5 μs |
| 40,000 | 503.3 μs |
| 57,800 | 983.3 μs |
可以看到,随着位置往后,单次查询耗时大致呈线性增长。这下可算是实锤了。
原生逆袭之龙王归来
绕过是绕过了,但手写 JS 也太让人膈应了……可恶,如果不能美丽地活着,那和死了无异吔!不过既然都知道原理了,是不是可以整点魔法绕过去?
原生,启动!
直觉上看,既然问题出在它回头去扫外部兄弟,那就加个 :scope 限制下作用域吧。
item.querySelector(":scope > .userContainer > strong > a.avatar[href]");可惜实测下来然并卵。想想也是,:scope 虽然锚定了选择器语义,却并没有提前停下 Blink 的预扫描阶段,它本身也单独构成一个 compound。这样外层依然拆出了多个 compound,Blink 照样会在横向扫描里空转。
那如果套层 :is(...) 呢?
const anchor = item.querySelector(
  ":is(.userContainer > strong > a.avatar[href])",
);
在有约 5.8 万个好友的页面末尾条目上测试:
| 写法 | 单次平均耗时 |
|---|---|
| 原选择器 | 879 μs |
:scope > 原选择器 |
800 μs |
| 手写 JS 过滤 | 1.10 μs |
:is(原选择器) |
0.35 μs |
捏嘿~这不是很有效嘛!原理还挺巧妙:套上 :is(...) 之后,整个选择器在语法层面被打包成了单个伪类,SelectorQuery 眼里外层 compound 数量和 agent 的写法一样也只剩一个了,因此跳过了前面的扫描逻辑,内部的复杂选择器则交由后续的完整检查来匹配。
哎呀,现在不仅规避了退化的逻辑,纯 C++ 内部匹配也省下了手写 JS 的 DOM Binding 开销。虽然只是找到了个临时绕过问题的 trick,但这种感觉真是爽快啊!就像是穿着新内裤迎接新年到来的早晨一样舒爽呢~
事已至此,先提个 Issue 吧
嘻嘻,真是难得看 Chromium 内核出丑。虽然我自己的组件通过换写法绕过去了,但我还要将咕噜咕噜这丑态复制数亿份,免费给世人欣赏口牙!
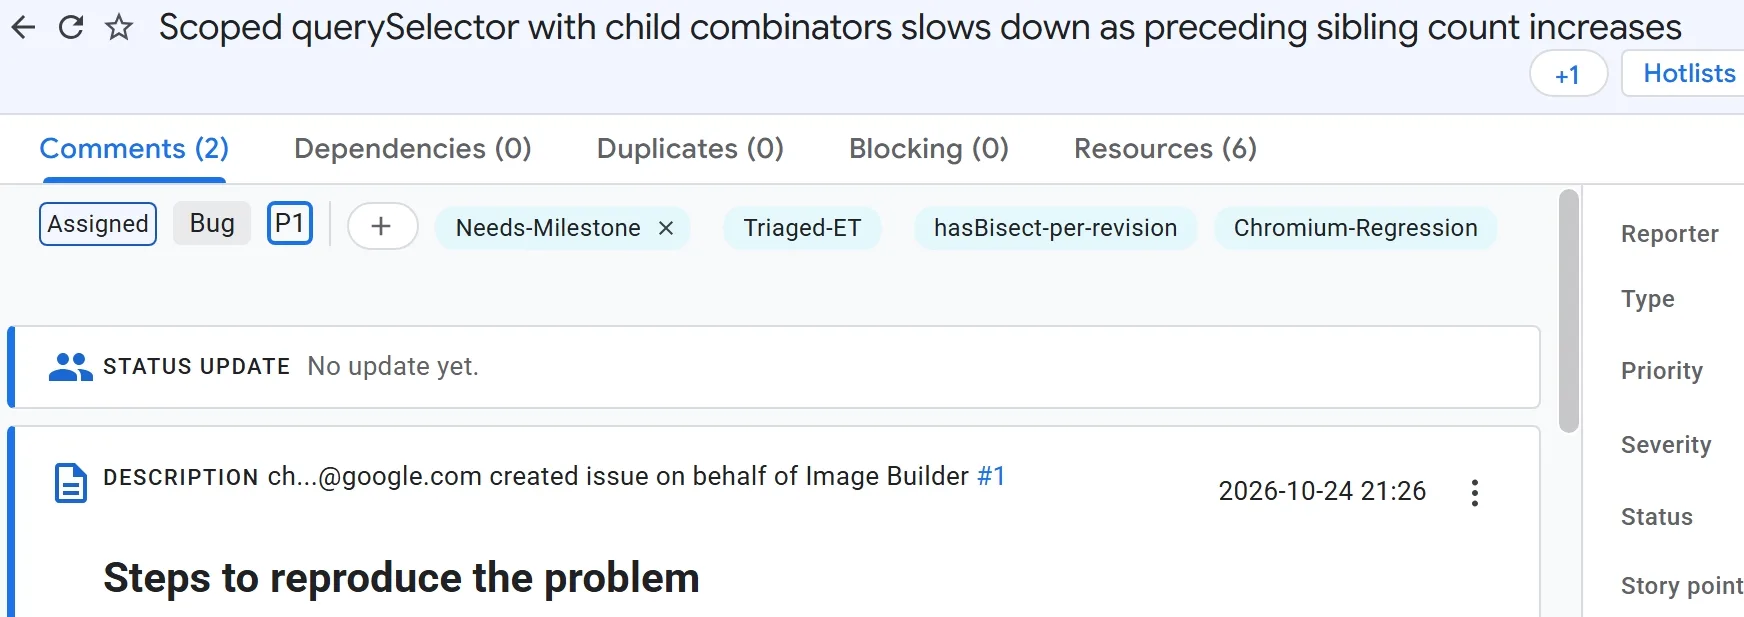
去 Chromium Issue Tracker 搜了一圈,怎么还真没人报过一模一样的退化情况?简单整了个独立复现 HTML,连同基准测试数据搓了 Issue 577162419 丢了上去,坐等 Blink CSS 开发团队修复吧。
结语
可算是码完了。我写组件的时候,大抵也没想到后面居然一路摸进 Chromium 源码了罢。顺带一提,这问题也是拿到了个 P1 优先级,不过现在依然没什么动静就是了……P1 竟是如此不稀罕之物?
再多一眼看一眼就会爆炸 Assignee……sesse?我依稀记得之前叫大伙把 MySQL 换成 PostgreSQL 的是不是就他来着?当初这段重构代码竟然是他写的。又翻了翻 Chromium 的代码评审系统 Gerrit,发现他显示名后面挂着 (no longer in Chromium)。不是哥们,合着已经不在 Chromium 了啊,工单机器人这是在派给谁看?悠悠苍天,此何人哉!
一直等着等着,慢死了!俗话说得好,自己动手丰衣足食。源码挖到了这种地步,已经不是言语能解决的吧!领域补丁展开!
下一话:向南 To be continued…